Website für KI optimieren: Checkliste für die KI-Suche
Das Wichtigste in Kürze
- Eine Website für KI zu optimieren heißt, Crawlern Zugang zu geben, das Unternehmen eindeutig zu beschreiben und Kundenfragen in zitierfähigen Absätzen zu beantworten.
- Die Such-Crawler OAI-SearchBot, Claude-SearchBot und PerplexityBot brauchen freien Zugang über robots.txt und Firewall. Sonst fehlt die Seite in der KI-Websuche.
- Laut Google-Leitfaden (Stand September 2026) braucht die Google Suche weder eine llms.txt noch spezielles Schema-Markup noch in kleine Stücke zerlegte Inhalte.
- Die Entität entsteht aus Organization- oder LocalBusiness-Markup mit sameAs, einem Wikidata-Eintrag und gleichen Angaben zu Name, Adresse und Leistung überall im Web.
- Zitiert werden Absätze, die eine Kundenfrage im ersten Satz beantworten und prüfbare Angaben wie Preis, Dauer oder Frist enthalten.
- Seit Juni 2026 zeigt die Search Console einem Teil der Websites einen Leistungsbericht zu generativen KI-Funktionen mit Impressionen je Seite.
Eine Website für KI zu optimieren heißt, sie so aufzubereiten, dass KI-Systeme wie ChatGPT, Claude, Perplexity und die KI-Funktionen der Google Suche sie finden, verstehen und in ihren Antworten nennen. Die Checkliste unten nennt zu jeder Maßnahme Aufwand, Wirkung und einen Prüfweg, den du in wenigen Minuten selbst ausführst. Wer seine Website in KI sichtbar machen will, beginnt mit den Punkten, die wenig kosten und viel bewirken. Die Grundbegriffe erklärt die Übersicht zur GEO-Optimierung.
So wählen KI-Systeme ihre Quellen
KI-Systeme kommen auf drei Wegen zu einer Antwort. Das Modellwissen stammt aus Trainingsdaten und ist oft Monate alt. Die Live-Websuche ruft Seiten ab, während jemand fragt: bei ChatGPT über OAI-SearchBot und externe Suchanbieter, bei Claude über Claude-SearchBot und bei Perplexity über PerplexityBot. Die KI-Übersichten und der KI-Modus von Google greifen auf den Google-Index zu.
Google beschreibt diesen dritten Weg im eigenen Leitfaden genauer. Das System zerlegt eine Frage in mehrere verwandte Suchanfragen, ruft dazu passende Seiten aus dem Index ab und formuliert daraus eine Antwort mit Links auf die Quellen.
Für die eigene Website folgen daraus drei Stufen. Zuerst muss ein Crawler die Seite abrufen können. Dann muss das System erkennen, wer hinter der Seite steht und welche Frage sie beantwortet. Erst danach kann es die Marke nennen oder die Seite als Quelle verlinken. Jede Stufe setzt die vorherige voraus.
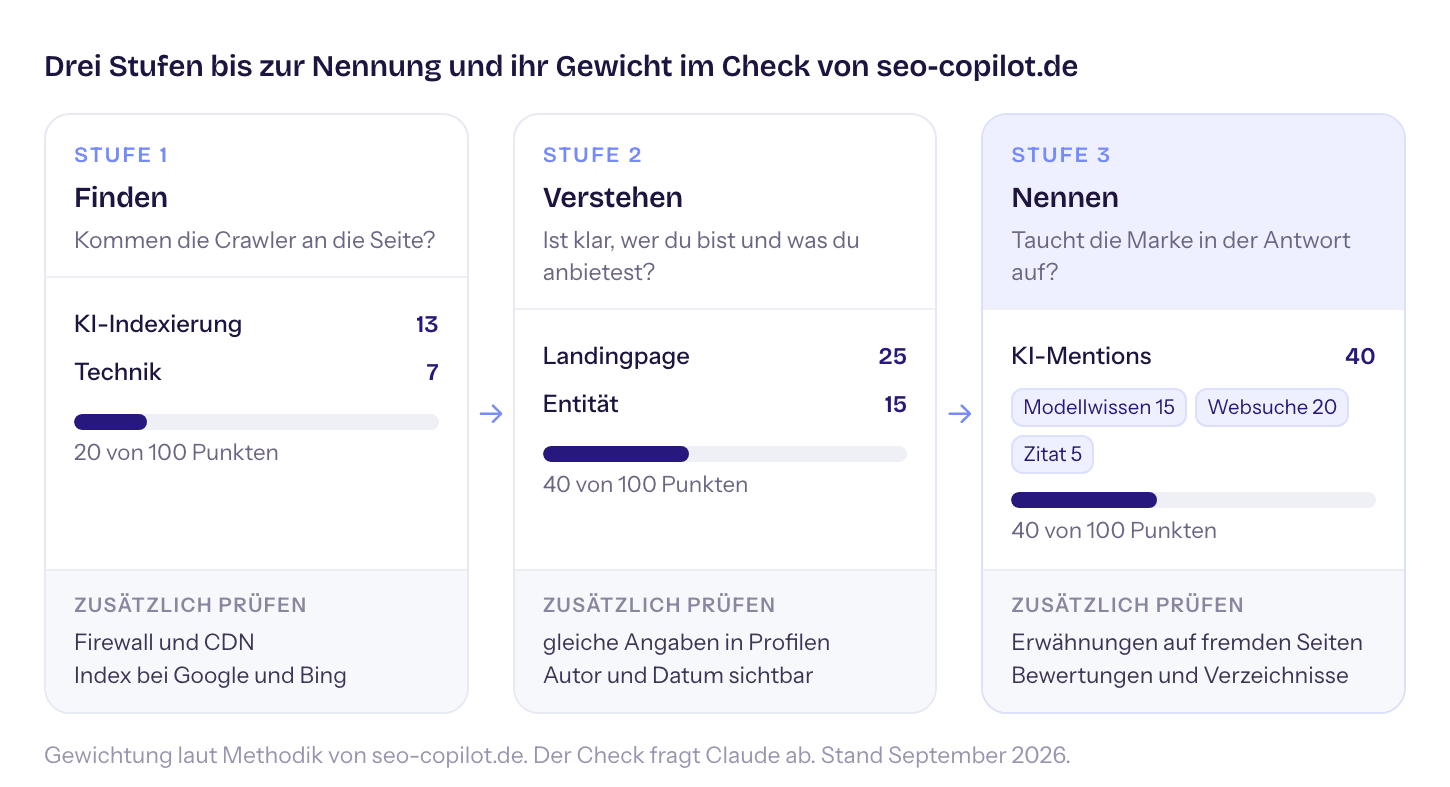
Im Check von seo-copilot.de entfallen 20 von 100 Punkten auf das Finden (KI-Indexierung 13, Technik 7). Weitere 40 Punkte gehören zum Verstehen (Landingpage 25, Entität 15), und die letzten 40 bewerten die Nennung selbst (KI-Mentions).
Die Checkliste mit Aufwand, Wirkung und Prüfweg
Geringer Aufwand heißt unter einer Stunde, mittlerer bis zu einem Arbeitstag und hoher mehrere Wochen. Die Spalte „Wirkung“ gibt meine Einschätzung aus der Arbeit am Check wieder. Eine eigene Messreihe dazu gibt es bisher nicht. Die letzte Spalte zeigt, welches der fünf Kriterien des Checks den Punkt abdeckt. Bei „außerhalb“ prüfst du selbst.
Ersetze in den Befehlen deine-domain.de durch deine Adresse. Das Werkzeug curl ist auf macOS, Linux und Windows 10 vorinstalliert.
| Maßnahme | Aufwand | Wirkung | Prüfweg | Kriterium im Check |
|---|---|---|---|---|
| Such-Crawler in der robots.txt erlauben | gering | hoch | curl -s https://deine-domain.de/robots.txt | KI-Indexierung |
| Bot-Schutz von Firewall und CDN prüfen | gering | hoch | curl -I -A "PerplexityBot" https://deine-domain.de/ liefert Status 200 | außerhalb |
| HTTPS mit Weiterleitung von http | gering | mittel | curl -I http://deine-domain.de/ zeigt 301 | Technik |
| sitemap.xml bereitstellen | gering | mittel | curl -I https://deine-domain.de/sitemap.xml zeigt 200 | Technik |
| Indexierung bei Google und Bing | gering | hoch | URL-Prüfung in Search Console und Bing Webmaster Tools | außerhalb |
| Snippets zulassen | gering | hoch | Quelltext und HTTP-Header nach nosnippet durchsuchen | außerhalb |
| Freigabe für generative KI in der Search Console | gering | hoch | Search Console unter Einstellungen > Generative KI in der Google Suche | außerhalb |
| Kerninhalt ohne JavaScript im HTML | mittel | hoch | Seitenquelltext im Browser öffnen und Kernsatz suchen | Landingpage |
| Title und Description sowie genau eine H1 | gering | mittel | curl -s https://deine-domain.de/ und nach <title> und <h1 suchen | Landingpage |
| Organization oder LocalBusiness als JSON-LD | mittel | mittel | Prüfung mit validator.schema.org | Landingpage und Entität |
| sameAs auf eigene Profile | gering | mittel | Prüfung mit validator.schema.org | Entität |
| Wikidata-Eintrag mit offizieller Website (P856) | mittel | mittel | Suche auf wikidata.org | Entität |
| gleiche Angaben zu Name und Adresse und Leistung | mittel | hoch | Impressum mit Unternehmensprofil und Verzeichnissen vergleichen | teilweise Entität |
| Kundenfragen als Überschrift mit Antwort im ersten Satz | hoch | hoch | fünf Kundenfragen in ChatGPT und Claude stellen | KI-Mentions |
| Autor und Änderungsdatum sichtbar | gering | mittel | Artikelkopf und dateModified im Quelltext | außerhalb |
| Erwähnungen auf fremden Seiten | hoch | hoch | Quellenlisten der KI-Antworten auswerten | KI-Mentions |
| llms.txt anlegen | gering | gering | curl -I https://deine-domain.de/llms.txt | KI-Indexierung mit 5 Punkten |
| Crawler-Besuche messen | gering | mittel | Server-Log oder WordPress-Plugin | außerhalb |
Technik: Zugang für die Crawler
KI-Crawler gibt es in zwei Arten. Trainings-Crawler wie GPTBot und ClaudeBot sammeln Texte für künftige Modelle. Such-Crawler wie OAI-SearchBot, Claude-SearchBot und PerplexityBot holen Seiten in dem Moment, in dem jemand fragt. Wer in Antworten mit Quellenlink auftauchen will, lässt die Such-Crawler zu. Die Trainings-Crawler kannst du getrennt davon sperren. Welche Kombination zu welchem Geschäftsmodell passt, steht im Beitrag KI-Crawler erlauben oder blockieren.
Die robots.txt ist nur die halbe Antwort. Das hab ich öfter gesehen, als mir lieb ist: Die robots.txt erlaubt alles, und der Bot-Schutz des CDN antwortet dem Crawler trotzdem mit 403. Der Test mit curl zeigt Sperren nach User-Agent. Manche CDNs erkennen Bots zusätzlich an der IP-Adresse. Ein 403 im Test ist deshalb ein Hinweis und noch kein Beweis. Den Beleg liefert das Server-Log mit echten Zugriffen.
Auf WordPress-Seiten übernimmt das unser Plugin: KI-Crawler in WordPress messen. Es erkennt 42 Crawler-Signaturen und kostet im Mittel 0,9 ms pro Anfrage, gemessen über 1.200 Requests. Eine Grenze gilt für jedes Werkzeug dieser Art. Antwortet ein Full-Page-Cache, erreicht die Anfrage PHP gar nicht, und der Tracker zählt zu wenig.
Viele KI-Crawler werten nur das HTML aus, das der Server ausliefert. Was erst per JavaScript nachgeladen wird, sehen sie möglicherweise nicht. Google verarbeitet JavaScript, solange es nicht gesperrt ist.
Für die KI-Funktionen der Google Suche nennt der Leitfaden zwei Voraussetzungen. Die Seite muss indexiert und mit Snippet anzeigbar sein. Außerdem muss die Website in der Search Console in generative KI-Funktionen einbezogen sein. Das regelt die Einstellung unter „Einstellungen > Generative KI in der Google Suche“. Laut Search-Console-Hilfe ist die Freigabe für jede Property voreingestellt. Wer dort ausschließt, verschwindet aus den Übersichten mit KI, dem KI-Modus und den KI-Funktionen in Discover. Ein nosnippet im Meta-Tag oder im X-Robots-Tag nimmt eine einzelne Seite ebenfalls heraus, weil sie dann nicht mehr mit Snippet anzeigbar ist.
Google erwähnt außerdem Browser-Agenten, die Seiten über Screenshots, die DOM-Struktur und den Barrierefreiheitsbaum auslesen. Saubere Landmarks und Überschriften helfen dabei. Wie das im Code aussieht, zeigt html-einfach.de im Beitrag zu Landmarks und Dokumentgliederung.
Entität: wer hinter der Website steht
Eine Entität ist für ein KI-System ein eindeutig bestimmbares Ding, also eine Firma, eine Person oder ein Ort. Je widerspruchsfreier die Angaben zu deinem Unternehmen im Web sind, desto sicherer ordnet ein System eine Frage deinem Betrieb zu.
Auf der Website gehört dazu ein JSON-LD-Block vom Typ Organization oder LocalBusiness mit Name, Adresse, Logo und sameAs-Verweisen auf Unternehmensprofil, LinkedIn und Wikidata. Einen Baustein zum Kopieren enthält der Beitrag zu strukturierten Daten für die KI-Suche. Google braucht laut Leitfaden kein spezielles Markup für die KI-Funktionen. Das Markup bleibt trotzdem eine eindeutige Selbstauskunft, die andere Systeme lesen können, und es hält die Seite für Rich Results geeignet.
Außerhalb der Website zählt ein Wikidata-Eintrag mit der Eigenschaft P856 für die offizielle Website. Dazu kommen gleichlautende Angaben in Unternehmensprofil, Branchenverzeichnissen und Impressum. Ein abweichender Firmenname auf einer Plattform kann reichen, damit ein System zwei Einträge nicht mehr sicher zusammenführt.
Inhalte, die sich zitieren lassen
KI-Systeme übernehmen Sätze, die eine Frage vollständig beantworten. Die Kundenfrage steht als Überschrift. Der erste Satz darunter beantwortet sie. Prüfbare Angaben wie Preis, Dauer oder Frist ersetzen Adjektive.
Ein ausgedachtes Beispiel eines Dachdeckers zeigt den Unterschied. Der Satz „Wir bieten schnelle und zuverlässige Reparaturen“ enthält nichts, was ein System übernehmen kann. Der Satz „Nach einem Sturmschaden sind wir im Stadtgebiet innerhalb von 24 Stunden vor Ort“ enthält eine Zusage mit Ort und Frist. Genau solche Sätze tauchen in Antworten wieder auf.
Google schreibt im Leitfaden, dass Inhalte nicht in winzige Abschnitte zerlegt werden müssen. Das widerspricht der Gliederung nach Fragen nicht. Überschriften, die Fragen benennen, helfen zuerst den Lesern und damit auch den Systemen, die den passenden Abschnitt suchen. Mehr Gewicht legt Google auf Inhalte mit eigener Perspektive, etwa Erfahrungsberichte oder eigene Messungen. Zusammenfassungen dessen, was anderswo steht, bringen laut Leitfaden wenig eigene Einsicht.
Autor und Änderungsdatum im Artikelkopf zeigen, wer spricht und wie aktuell die Angabe ist.
Ich halte diesen Block für den mit dem größten Hebel. Er wird trotzdem am häufigsten übersprungen, weil er redaktionelle Arbeit kostet und sich nicht per Plugin erledigen lässt.
Quellen außerhalb der Website
Die Live-Websuche zitiert oft fremde Seiten über dich: Vergleichsportale, Branchenverzeichnisse, Kammern, Lokalzeitungen und Foren. Ein Blick in die Quellenlisten der Antworten auf deine fünf wichtigsten Kundenfragen zeigt, welche Seiten das in deiner Branche sind. Dort aufzutauchen dauert Monate und hängt an Leistung, Bewertungen und Kontakten.
Google warnt im Leitfaden davor, unauthentische Erwähnungen zu erzeugen. Gekaufte Listeneinträge und bestellte Forenbeiträge helfen demnach wenig. Die Ranking-Systeme achten auf Qualität, und eigene Systeme sortieren Spam aus.
Lokale Anbieter: Profil, Bewertungen und Ortsbezug
Für Handwerker, Praxen, Kanzleien und Hotels kommt eine Ebene hinzu. Der Google-Leitfaden nennt Unternehmensprofile als Weg, damit Dienstleistungen in KI-Antworten und anderen Suchergebnissen erscheinen. ChatGPT und Perplexity greifen für lokale Empfehlungen auf Bewertungsportale, Verzeichnisse und Kartendienste zurück.
- Das Unternehmensprofil bei Google ist vollständig: Kategorie, Leistungen, Öffnungszeiten und Fotos.
- Das
LocalBusiness-Markup nennt Adresse, Geo-Koordinaten und Einzugsgebiet überareaServed. - Eigene Seiten für Orte entstehen nur dann, wenn dort andere Inhalte stehen als auf der nächsten Ortsseite.
- Bewertungen werden aktiv erbeten und beantwortet.
- Der Selbsttest nutzt lokale Fragen wie „Welcher Maler in München streicht auch Treppenhäuser im Altbau?“.
Den ausführlichen Weg beschreibt der Beitrag zur KI-Sichtbarkeit für lokale Unternehmen.
Was Google laut Leitfaden nicht braucht
Google hat am 15. Mai 2026 einen Leitfaden zu generativen KI-Funktionen veröffentlicht und am 10. Juli 2026 zuletzt aktualisiert. Stand September 2026 nennt der Leitfaden von Google diese Punkte als verzichtbar für die Google Suche:
- llms.txt und andere KI-Textdateien: Die Google Suche verwendet sie nicht.
- Aufteilen von Inhalten: Googles Systeme erkennen mehrere Themen auf einer Seite und zeigen den passenden Teil.
- Umschreiben für KI: Die Systeme verstehen Synonyme und die allgemeine Bedeutung einer Frage.
- Unauthentische Erwähnungen: Sie helfen weniger, als es scheint.
- Spezielles Schema-Markup: Strukturierte Daten sind keine Voraussetzung. Für Rich Results bleiben sie sinnvoll.
Diese Aussagen gelten für Google. ChatGPT, Claude und Perplexity haben eigene Crawler und eigene Regeln.
Ich halte die llms.txt für den am stärksten überschätzten Punkt jeder GEO-Checkliste. Die Datei kostet eine halbe Stunde und schadet laut Google nicht. Ob ein anderes System sie auswertet, ist Stand September 2026 nicht belegt. Im Check von seo-copilot.de zählt sie 5 von 100 Punkten, und in der Tabelle oben steht sie mit geringer Wirkung.
Prüfen, ob es wirkt
Vor der ersten Änderung steht ein Ausgangswert. Unser Check fragt Claude zweimal, einmal aus dem Modellwissen und einmal mit Websuche. Dazu bewertet er die fünf Kriterien aus der Tabelle. Andere KI-Systeme misst er Stand September 2026 nicht. Du kannst deine KI-Sichtbarkeit prüfen und den Report als Ausgangswert speichern.
Für ChatGPT und Perplexity stellst du fünf Kundenfragen in je drei neuen Chats und protokollierst, wer genannt wird. Für Google zeigt die Search Console seit dem 3. Juni 2026 einem Teil der Websites einen eigenen Leistungsbericht zu generativen KI-Funktionen. Er listet Impressionen in AI Overviews, KI-Modus und Discover nach Seite, Land und Zeitraum.
In unserer eigenen Search Console tauchen zwischen Juni und September 2026 Suchanfragen auf, die wie Prompts klingen. Eine davon lautet „welche rolle spielen strukturierte daten (json-ld / schema.org) für die sichtbarkeit in ki-generierten antworten und wo sind ihre grenzen?“ und erreichte Position 8. Solche Fragen gehören wörtlich als Überschrift auf die passende Seite.
Nach vier bis acht Wochen misst du mit denselben Fragen erneut. Änderungen an Technik und Markup zeigen sich in der Websuche früher als im Modellwissen. Das Modellwissen zieht erst mit einer neuen Modellversion nach.
Rankings hängen von Faktoren ab, die sich einzeln nicht garantieren lassen. Dieser Beitrag beschreibt ein Vorgehen und sichert keine Ergebnisse zu.
Häufige Fragen
Wie mache ich meine Website für KI sichtbar?
Du machst deine Website für KI sichtbar, indem du drei Stufen nacheinander absicherst. Zuerst gibst du den Such-Crawlern Zugang über robots.txt und Firewall. Dann beschreibst du dein Unternehmen eindeutig mit JSON-LD, sameAs und gleichen Angaben auf allen Profilen. Zuletzt beantwortest du Kundenfragen in Absätzen, die eine KI wörtlich übernehmen kann. Nach vier bis acht Wochen prüfst du, ob dich die Systeme nennen.
Brauche ich eine llms.txt?
Für die Google Suche brauchst du keine llms.txt. Google schreibt im Leitfaden zu generativen KI-Funktionen (Stand September 2026), dass die Suche solche Dateien nicht verwendet. Ob ChatGPT, Claude oder Perplexity sie auswerten, ist nicht belegt. Die Datei schadet nicht und ist in einer halben Stunde angelegt. Sinnvoll ist sie erst, wenn Crawler-Zugang, Entität und Inhalte stehen.
Wie lange dauert es, bis KI-Systeme Änderungen übernehmen?
Das hängt vom Weg ab, über den ein System antwortet. Die Live-Websuche sieht eine Änderung, sobald der Crawler die Seite neu abruft. Das dauert meist Tage bis Wochen. In den KI-Funktionen von Google erscheint sie nach der nächsten Indexierung. Das Modellwissen ändert sich erst mit einer neuen Modellversion und damit oft nach Monaten. Miss deshalb frühestens nach vier Wochen nach.
Kann ich das selbst umsetzen?
Die meisten Punkte der Checkliste setzt du ohne Agentur um. robots.txt, Weiterleitungen, Title, Description und Unternehmensprofil erledigt jemand mit Zugang zum CMS an einem Nachmittag. Für JSON-LD genügt ein Plugin oder ein kopierter Baustein. Aufwendig sind die zitierfähigen Inhalte und die Erwähnungen auf fremden Seiten. Dort liegt der größte Teil der Arbeit, und dort hilft Wissen über die eigene Branche mehr als SEO-Technik.
Miss vor der ersten Änderung, wo deine Website heute steht. Dann siehst du später, was die Checkliste bewirkt hat.
KI-Sichtbarkeit prüfen →